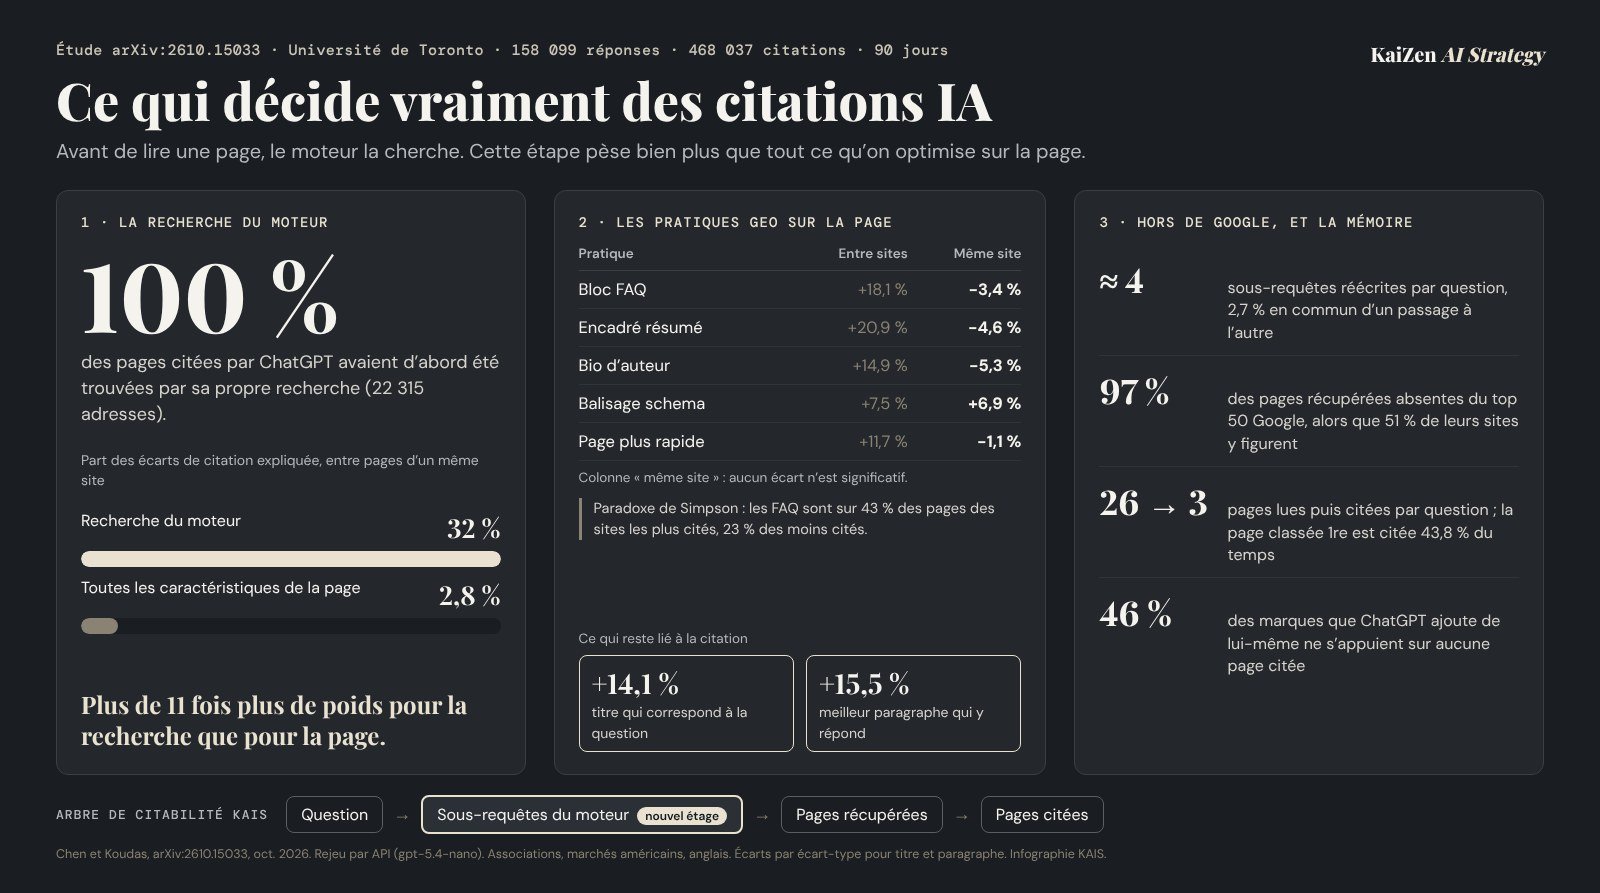
Une page n’est citée par ChatGPT que si sa propre recherche l’a d’abord trouvée, et cette étape pèse plus de dix fois plus que tout ce qu’on optimise sur la page. C’est le résultat central d’une étude publiée le 10 octobre 2026 par Mahe Chen et Nick Koudas, de l’université de Toronto. Entre les pages d’un même site, l’étape de recherche explique 32 % des écarts de citation. L’ensemble des caractéristiques de la page, du bloc FAQ au balisage schema en passant par la vitesse, en explique 2,8 %.
Le chiffre qui fonde le reste est sec. Les chercheurs ont rejoué leurs questions dans ChatGPT par son API, recherche web activée, et ont récupéré pour chaque réponse les requêtes envoyées et la liste des pages trouvées. Sur 22 315 adresses citées, 100 % figuraient dans cette liste. Le moteur ne cite rien qu’il n’a pas cherché.
Le travail GEO courant commence par la page : on ajoute une FAQ, du schema, un encadré résumé, une bio d’auteur. L’étude déplace le point de départ. Avant la page, il y a une recherche que le moteur écrit lui-même et que personne ne voit. C’est pour cette raison que KAIS ajoute un étage à son arbre de citabilité.
Qu’a mesuré l’étude de Toronto ?
L’étude arXiv:2610.15033 croise 90 jours de réponses, un rejeu des recherches des moteurs et des expériences contrôlées, sur deux marchés opposés. Le premier est l’accès internet résidentiel aux États-Unis, dominé par quelques grandes marques : 651 questions, 143 249 réponses, 396 188 citations. Le second est une niche, les logiciels de propositions commerciales pour cabinets d’architecture et d’ingénierie : 55 questions, 14 850 réponses, 71 849 citations. Au total, 158 099 réponses et 468 037 citations de ChatGPT, Gemini et Perplexity.
Le dispositif compare surtout les pages d’un même site entre elles, et c’est ce choix qui rend l’étude utile. Comparer des sites différents mélange l’effet d’une pratique et l’effet de la notoriété du site. Comparer deux pages du même site neutralise le second. Le rejeu a tourné 13 fois sur 11 jours, jusqu’au 7 octobre 2026, avec gpt-5.4-nano pour ChatGPT et gemini-3.1-flash-lite pour Gemini. Perplexity n’a pas pu être rejoué.
Comment ChatGPT cherche-t-il avant de répondre ?
ChatGPT réécrit chaque question en quatre requêtes environ, courtes, à la manière de mots-clés, et il les réécrit autrement à chaque réponse. Ces sous-requêtes ne gardent que 43 % des mots de la question. 23 % ajoutent l’année en cours. 28 % ajoutent une marque que l’utilisateur n’a pas nommée. Gemini écrit plutôt trois sous-questions en langage naturel, plus proches de la question d’origine.
Ces requêtes bougent beaucoup. Entre deux passages de la même question le même jour, celles de ChatGPT ne se recoupent qu’à 2,7 %, et les pages citées à 15 %. Elles ont l’air de mots-clés, mais le classement suit le sens : la position d’une page est plus liée à sa proximité sémantique avec les requêtes (corrélation de 0,20) qu’à la correspondance de leurs mots (0,08).
Pour chaque question, ChatGPT consulte en moyenne 26 pages et en cite 3. Il les prend en haut de sa propre liste. 43,8 % des pages classées premières sont citées, 35,5 % des deuxièmes, 12,2 % de celles placées entre la sixième et la dixième place, 3,5 % entre la onzième et la vingtième.
Une sous-requête du moteur est une requête qu’un moteur de réponse écrit lui-même à partir de la question de l’utilisateur, puis envoie à son outil de recherche. Dans l’étude arXiv:2610.15033, ChatGPT en écrit environ quatre par question, et chaque page qu’il cite a d’abord été trouvée par l’une d’elles.
Être premier sur Google suffit-il ?
Non : 97 % des pages que ChatGPT récupère sont absentes du top 50 de Google pour ses propres requêtes, et 99 % du top 30 de Bing. Gemini s’appuie pourtant sur la recherche Google, et 93 % des pages qu’il cite sont hors de ce même top 50. Les résultats publics ont été relevés depuis les États-Unis, à un ou deux jours du rejeu. Ni le lieu ni la date n’expliquent l’écart.
Le détail qui compte est ailleurs. 51 % des sites de ces pages figurent bien dans le top 50 de Google. Les moteurs choisissent souvent les mêmes sites que Google, mais pas les mêmes pages. Pour une marque, la page que Google classe et la page que ChatGPT récupère ne sont pas forcément les mêmes. L’écart entre les deux classements fait l’objet de Premier sur Google, invisible dans ChatGPT.
FAQ, schema, encadré résumé : qu’est-ce qui compte encore ?
Entre deux pages d’un même site, aucune des pratiques GEO les plus recommandées n’est liée à davantage de citations. Les écarts mesurés pour ChatGPT : −3,4 % pour un bloc FAQ, +6,9 % pour le balisage schema, −4,6 % pour un encadré résumé, −5,3 % pour une bio d’auteur, −1,1 % pour une page plus rapide. Aucun n’est significatif.
Entre sites différents, les mêmes pratiques ont l’air de marcher. Le bloc FAQ y va avec 18,1 % de citations en plus. Les auteurs y voient un paradoxe de Simpson. Les FAQ figurent sur 43 % des pages du quart des sites les plus cités, et sur 23 % des pages du quart le moins cité. La comparaison entre sites attribue à la FAQ ce qui revient au site.
Deux caractéristiques passent les cinq tests de robustesse de l’étude. La première est un titre qui correspond aux questions posées : +14,1 % de citations par écart-type, +23,6 % sur les pages tierces, +26,4 % sur le marché B2B. La seconde est un paragraphe qui y répond : +15,5 % pour le meilleur paragraphe de la page, +25,7 % sur les pages tierces. Les deux agissent par la même étape. Une page dont le titre et un paragraphe correspondent, par le sens, aux requêtes du moteur remonte dans sa liste.
| Caractéristique de la page | Écart de citations | Robuste ? |
|---|---|---|
| Meilleur paragraphe qui répond à la question | +15,5 % | Oui |
| Titre qui correspond à la question | +14,1 % | Oui |
| Balisage schema | +6,9 % | Non |
| Page plus rapide | −1,1 % | Non |
| Bloc FAQ | −3,4 % | Non |
| Encadré résumé | −4,6 % | Non |
| Bio d’auteur | −5,3 % | Non |
Une fois les pages dans la liste du moteur, quelques traits pèsent encore sur le choix final, à rang égal. Les pages de marque sont plus citées (×1,71), comme les pages qui ont plus d’intertitres (×1,28) et les pages plus courtes. Les listes (×0,54), les comparatifs (×0,34) et les fils Reddit (×0,30) sont souvent consultés et rarement cités. FAQ, schema et bio d’auteur n’apportent rien à cette étape non plus.
Que fait la mémoire du modèle dans tout ça ?
Le modèle écrit dans ses recherches les marques qu’il connaît déjà, et il en nomme sans aucune page à l’appui. Quand une marque fait partie de ce que le modèle associe à une question, ChatGPT l’ajoute à ses requêtes dans 67 % des cas, contre 11 % sinon. Et 46 % des marques que ChatGPT mentionne sans que la question les nomme ne s’appuient sur aucune page citée.
Le marché de niche montre l’autre face. Les modèles connaissent à peine les petits éditeurs de logiciels. ChatGPT ne les ajoute presque jamais à ses requêtes (3 % contre 28 %) et les découvre dans un premier tour de résultats. Une page tierce citée qui nomme un éditeur multiplie par 39,7 les chances que ChatGPT le nomme à son tour, contre 4,2 pour les grandes marques. Pour une marque peu connue des modèles, la visibilité passe par des pages tierces que la recherche du moteur trouve.
Les résultats tiennent-ils dans le temps ?
Mal : ce qui explique les citations d’un site change vite, et plus vite encore chez Perplexity. Sur une fenêtre de deux semaines, 63 % à 67 % des écarts entre pages se répètent. Deux semaines plus tard, la part commune tombe à 40 % pour ChatGPT, 47 % pour Gemini et 22 % pour Perplexity. Dix semaines plus tard, il en reste 14 %, 29 % et 0 %.
Les auteurs listent leurs limites. Leurs résultats sont des associations, sauf pour les expériences contrôlées sur l’étape de réponse. Les deux marchés sont américains et anglophones. Le rejeu passe par de petits modèles d’API, qui ne sont pas l’interface que voit le public. Une autre étude parue le lendemain (arXiv:2610.15382) mesure cet écart : l’API d’OpenAI et Google réunis ne retrouvent qu’environ un quart des adresses citées par ChatGPT dans son interface web, et environ la moitié des sites.
Établi : dans le rejeu par API, toutes les pages citées par ChatGPT avaient été trouvées par sa recherche, et cette recherche explique bien plus les écarts entre pages d’un même site que les caractéristiques de la page. Non établi : que les mêmes proportions valent pour ChatGPT dans son interface publique, hors des États-Unis ou dans une autre langue que l’anglais. Non testé : l’effet d’une intervention, par exemple réécrire un titre et mesurer les citations avant et après.
Qu’est-ce que KAIS change dans sa méthode ?
KAIS ajoute un étage « sous-requêtes du moteur » à son arbre de citabilité. Jusqu’ici, l’arbre reliait la question de décision d’un acheteur aux questions secondaires qu’elle soulève, puis aux sources qui y répondent. Il passe désormais par la recherche du moteur : la question, les requêtes réécrites, les pages récupérées, les pages citées.
- Étage 1 · Question de décision« Quel cabinet choisir pour créer une société en Thaïlande ? »
- Étage 2 · Sous-requêtes du moteur nouvel étagecabinet création société Thaïlande 2026 frais enregistrement société Bangkok avis cabinet juridique Bangkok étrangers≈ 4 par question, réécrites à chaque réponse
- Étage 3 · Pages récupéréesLa liste que le moteur classe lui-même, souvent hors du top 50 de Google≈ 26 consultées par question
- Étage 4 · Pages citéesPrises en haut de cette liste≈ 3 par question
Le relevé change en premier. Les relevés KAIS sont faits à la main, dans les interfaces que voient les acheteurs. Quand ChatGPT affiche les recherches qu’il lance, le relevé les note désormais mot pour mot. Ce que l’interface ne montre pas reste vide : on ne le devine pas. Comme les requêtes changent d’une réponse à l’autre, on lit ce qui revient sur plusieurs passages, jamais une requête isolée.
Le diagnostic change ensuite. Une page absente d’une réponse peut échouer à deux endroits. Soit la recherche du moteur ne la trouve pas, et retoucher son contenu ne sert à rien tant que son titre et ses paragraphes ne correspondent pas à ces requêtes. Soit elle est trouvée sans être retenue, et c’est ce qu’elle contient, à rang égal, qui se joue. L’ancien arbre ne distinguait pas les deux cas. La méthode pour diagnostiquer une page précise est décrite dans Pourquoi l’IA ne cite pas votre page.
La production change enfin. Une page, une question. Un titre qui reprend la question telle que les acheteurs la posent. Un premier paragraphe qui y répond seul. Et pour une marque que les modèles connaissent mal, des pages tierces qui la nomment sur les bonnes questions. Une piste reste à vérifier, et c’est une lecture KAIS, pas un résultat de l’étude : puisque près d’une requête sur quatre ajoute l’année, une page qui porte une date tenue à jour pourrait mieux correspondre à ces requêtes.
Quatre règles que l’étude soutient
- Un titre qui pose la question : l’une des deux seules caractéristiques liées à la citation au sein d’un site.
- Un paragraphe qui répond seul : le meilleur paragraphe de la page pèse autant que le titre.
- Des pages tierces pour les marques peu connues : ×39,7 sur le marché de niche étudié.
- Pas de FAQ ni de schema pour la citation : ils peuvent servir le lecteur, mais aucun effet n’est mesuré au sein d’un site.
Où cela se situe-t-il dans l’AI Visibility Chain de KAIS ?
L’étude se situe à la deuxième étape de l’AI Visibility Chain de KAIS, Be Retrieved, et montre que Be Cited en dépend entièrement.
Be Discovered → Be Retrieved → Be Understood → Be Trusted → Be Cited → Influence the Answer → Be Recommended.
Elle touche aussi Be Trusted par la mémoire du modèle. Un site que le modèle associe déjà à une question est classé plus haut dans sa liste, et il a 1,60 fois plus de chances d’être cité à rang égal. La mémoire agit en amont de la recherche, en lui soufflant des marques, puis en aval, en nommant des marques sans source.
Le moteur pose ses propres questions
Pendant des années, le référencement a consisté à deviner les mots d’un internaute. Le moteur de réponse ajoute un intermédiaire. Il lit la question, écrit ses propres requêtes, et ne cite que ce qu’elles ramènent.
Une page peut être bien écrite, bien balisée, rapide, et ne jamais être citée, parce qu’aucune de ces requêtes ne la trouve. C’était l’étage qui manquait à l’arbre.
Sources et références
- Chen et Koudas — What Drives AI Citations? Content, Retrieval and Model Knowledge in Generative Engine Optimization (GEO), arXiv:2610.15033 [cs.IR], 10 octobre 2026, université de Toronto. Première version, non relue par des pairs. Données (section 3), caractéristiques des pages au sein d’un site et paradoxe de Simpson (section 4), stabilité dans le temps (section 5), rejeu des recherches, rangs et sous-requêtes (sections 6.1 à 6.3), part expliquée par la recherche (section 6.4), mémoire du modèle (section 6.5), second marché (section 7). Tous les chiffres de cet article viennent de l’étude ; aucun n’a été reproduit ni remesuré par KAIS.
- Jiang, Zhang, Xing, Chang et Xiao — Understanding ChatGPT Citations: Evidence from Production Web Search Across Model Generations, arXiv:2610.15382 [cs.IR], 11 octobre 2026. Écart entre l’API d’OpenAI, Google et ChatGPT dans son interface web : 26 % à 28 % des adresses citées retrouvées.