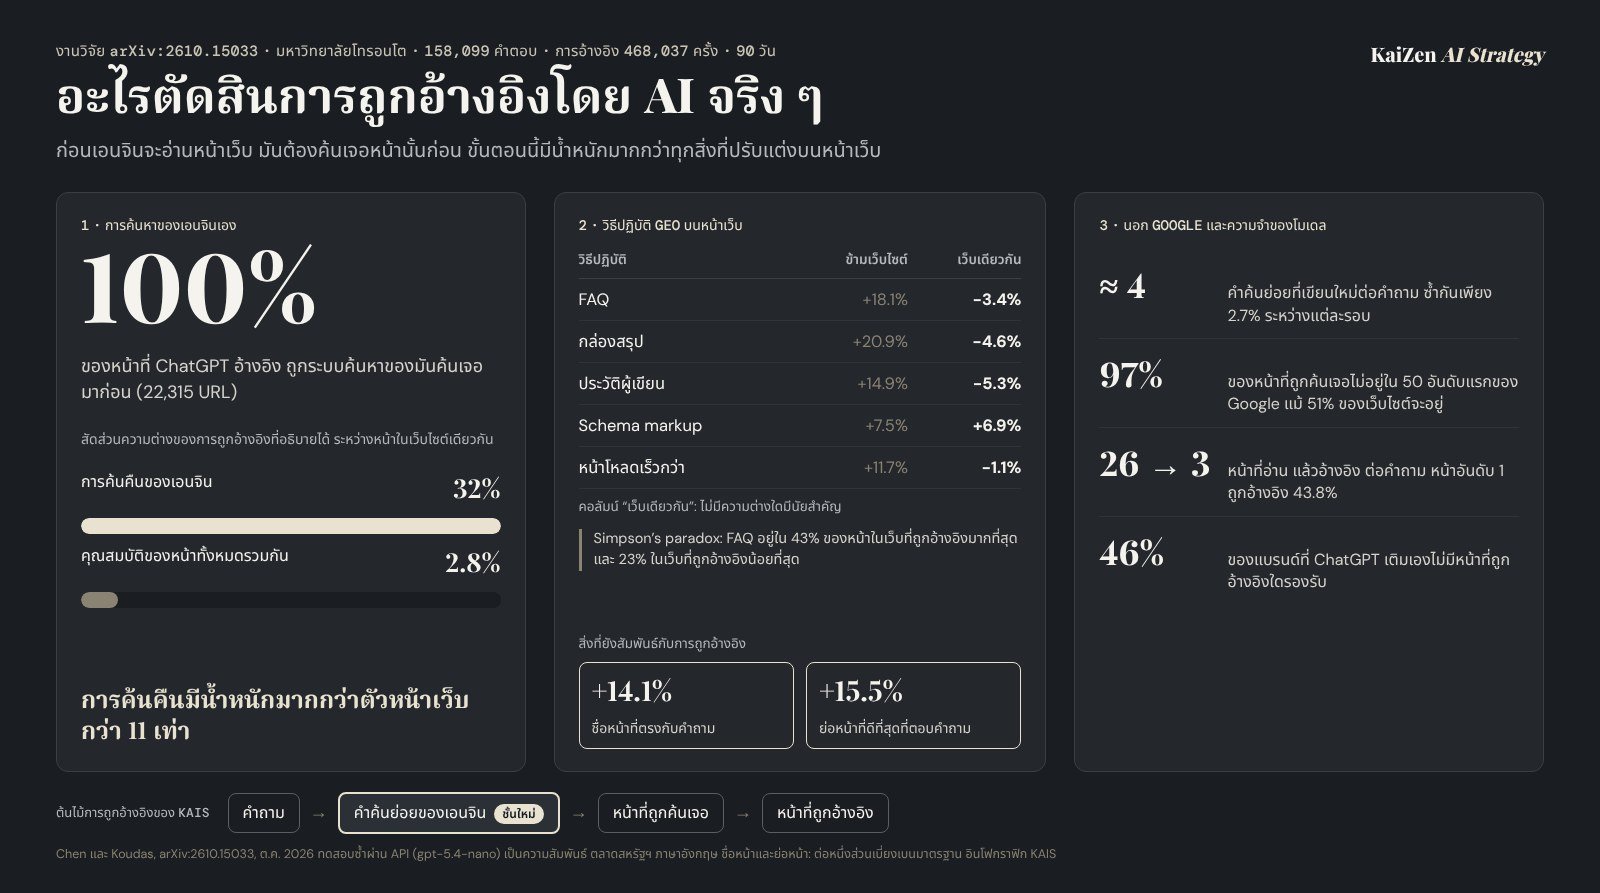
ChatGPT จะอ้างอิงหน้าเว็บก็ต่อเมื่อระบบค้นหาของมันค้นเจอหน้านั้นก่อน และขั้นตอนนี้มีน้ำหนักมากกว่าทุกอย่างที่เราปรับแต่งบนหน้าเว็บรวมกันกว่าสิบเท่า นี่คือผลลัพธ์หลักของงานวิจัยที่ Mahe Chen และ Nick Koudas จากมหาวิทยาลัยโทรอนโตเผยแพร่เมื่อวันที่ 10 ตุลาคม 2026 เมื่อเทียบหน้าต่าง ๆ ภายในเว็บไซต์เดียวกัน ขั้นตอนการค้นหาอธิบายความต่างของการถูกอ้างอิงได้ 32% ส่วนคุณสมบัติของหน้าทั้งหมดรวมกัน ตั้งแต่ FAQ, schema ไปจนถึงความเร็วหน้าเว็บ อธิบายได้เพียง 2.8%
ตัวเลขที่เป็นฐานของทุกอย่างนั้นตรงไปตรงมา นักวิจัยส่งคำถามชุดเดิมเข้า ChatGPT อีกครั้งผ่าน API โดยเปิดการค้นหาเว็บ และบันทึกคำค้นที่มันส่งออกไปกับรายการหน้าที่ได้กลับมาในทุกคำตอบ จาก URL ที่ถูกอ้างอิง 22,315 รายการ ทั้ง 100% อยู่ในรายการนั้น เอนจินไม่อ้างอิงสิ่งที่มันไม่ได้ค้น
งาน GEO ส่วนใหญ่เริ่มที่ตัวหน้าเว็บ เช่น เพิ่ม FAQ เพิ่ม schema เพิ่มกล่องสรุป เพิ่มประวัติผู้เขียน งานวิจัยนี้ย้ายจุดเริ่มต้น ก่อนจะถึงหน้าเว็บ มีการค้นหาที่เอนจินเขียนขึ้นเองและไม่มีใครเห็น นี่คือเหตุผลที่ KAIS เพิ่มชั้นใหม่ในต้นไม้การถูกอ้างอิง
งานวิจัยจากโทรอนโตวัดอะไร?
งานวิจัย arXiv:2610.15033 ใช้คำตอบจริง 90 วัน การส่งคำถามซ้ำเพื่อดูการค้นหาของเอนจิน และการทดลองแบบควบคุม ในสองตลาดที่ต่างกันมาก ตลาดแรกคืออินเทอร์เน็ตบ้านในสหรัฐอเมริกา ซึ่งมีแบรนด์ใหญ่ไม่กี่ราย มี 651 คำถาม 143,249 คำตอบ และการอ้างอิง 396,188 ครั้ง ตลาดที่สองเป็นตลาดเฉพาะกลุ่ม คือซอฟต์แวร์ทำข้อเสนองานสำหรับบริษัทสถาปัตยกรรมและวิศวกรรม มี 55 คำถาม 14,850 คำตอบ และการอ้างอิง 71,849 ครั้ง รวมทั้งหมด 158,099 คำตอบ และการอ้างอิง 468,037 ครั้งจาก ChatGPT, Gemini และ Perplexity
งานวิจัยนี้เน้นเปรียบเทียบหน้าในเว็บไซต์เดียวกัน และนี่คือสิ่งที่ทำให้มันมีประโยชน์ การเทียบข้ามเว็บไซต์จะปนผลของวิธีปฏิบัติเข้ากับผลของชื่อเสียงเว็บไซต์ การเทียบสองหน้าในเว็บเดียวกันตัดปัจจัยหลังออกไป การส่งคำถามซ้ำทำ 13 รอบใน 11 วัน จนถึงวันที่ 7 ตุลาคม 2026 โดยใช้ gpt-5.4-nano แทน ChatGPT และ gemini-3.1-flash-lite แทน Gemini ส่วน Perplexity ทำซ้ำไม่ได้
ChatGPT ค้นหาอย่างไรก่อนตอบ?
ChatGPT เขียนคำถามแต่ละข้อใหม่เป็นคำค้นสั้น ๆ แบบคีย์เวิร์ดประมาณสี่คำค้น และเขียนใหม่ไม่ซ้ำเดิมในทุกคำตอบ คำค้นย่อยเหล่านี้เก็บคำจากคำถามเดิมไว้เพียง 43% โดย 23% เติมปีปัจจุบันเข้าไป และ 28% เติมชื่อแบรนด์ที่ผู้ใช้ไม่ได้พูดถึง ส่วน Gemini มักเขียนคำถามย่อยแบบภาษาธรรมชาติราวสามข้อ ซึ่งใกล้เคียงคำถามเดิมมากกว่า
คำค้นเหล่านี้เปลี่ยนไปมาก ระหว่างสองรอบของคำถามเดียวกันในวันเดียวกัน คำค้นของ ChatGPT ซ้ำกันเพียง 2.7% และหน้าที่ถูกอ้างอิงซ้ำกัน 15% คำค้นดูเหมือนคีย์เวิร์ด แต่การจัดอันดับยึดตามความหมาย ตำแหน่งของหน้าสัมพันธ์กับความใกล้เคียงเชิงความหมายกับคำค้น (สหสัมพันธ์ 0.20) มากกว่าการตรงกันของคำ (0.08)
ในแต่ละคำถาม ChatGPT เปิดดูเฉลี่ย 26 หน้า และอ้างอิง 3 หน้า โดยเลือกจากส่วนบนสุดของรายการที่มันจัดอันดับเอง หน้าที่อยู่อันดับ 1 ถูกอ้างอิง 43.8% อันดับ 2 ถูกอ้างอิง 35.5% อันดับ 6 ถึง 10 ถูกอ้างอิง 12.2% และอันดับ 11 ถึง 20 เพียง 3.5%
คำค้นย่อยของเอนจิน คือคำค้นที่เอนจินคำตอบเขียนขึ้นเองจากคำถามของผู้ใช้ แล้วส่งไปยังเครื่องมือค้นหาของมัน ในงานวิจัย arXiv:2610.15033 ChatGPT เขียนประมาณสี่คำค้นต่อคำถาม และทุกหน้าที่มันอ้างอิงถูกค้นเจอด้วยคำค้นเหล่านี้มาก่อน
ติดอันดับหนึ่งบน Google พอหรือไม่?
ไม่พอ หน้าที่ ChatGPT ค้นเจอ 97% ไม่อยู่ใน 50 อันดับแรกของ Google สำหรับคำค้นของมันเอง และ 99% ไม่อยู่ใน 30 อันดับแรกของ Bing Gemini ใช้ Google Search เป็นฐาน แต่หน้าที่มันอ้างอิง 93% ก็อยู่นอก 50 อันดับแรกเดียวกันนี้ ผลการค้นหาสาธารณะเก็บจากตำแหน่งในสหรัฐฯ ภายในหนึ่งถึงสองวันหลังการทดสอบซ้ำ ทั้งสถานที่และเวลาจึงอธิบายช่องว่างนี้ไม่ได้
รายละเอียดที่สำคัญอยู่ที่อื่น เว็บไซต์ของหน้าเหล่านั้น 51% อยู่ใน 50 อันดับแรกของ Google จริง เอนจินมักเลือกเว็บไซต์เดียวกับ Google แต่ไม่ใช่หน้าเดียวกัน สำหรับแบรนด์ หน้าที่ Google จัดอันดับกับหน้าที่ ChatGPT ค้นเจออาจไม่ใช่หน้าเดียวกัน ช่องว่างระหว่างสองการจัดอันดับนี้อธิบายไว้ใน อันดับหนึ่งบน Google แต่ไม่มีตัวตนใน ChatGPT
FAQ, schema, กล่องสรุป: อะไรยังสำคัญอยู่?
เมื่อเทียบสองหน้าในเว็บไซต์เดียวกัน ไม่มีวิธีปฏิบัติ GEO ที่ถูกแนะนำบ่อยที่สุดข้อใดเลยที่สัมพันธ์กับการถูกอ้างอิงมากขึ้น ความต่างที่วัดได้สำหรับ ChatGPT คือ −3.4% สำหรับ FAQ, +6.9% สำหรับ schema, −4.6% สำหรับกล่องสรุป, −5.3% สำหรับประวัติผู้เขียน และ −1.1% สำหรับหน้าที่โหลดเร็วกว่า ไม่มีข้อใดมีนัยสำคัญทางสถิติ
เมื่อเทียบข้ามเว็บไซต์ วิธีปฏิบัติเดียวกันดูเหมือนได้ผล FAQ สัมพันธ์กับการถูกอ้างอิงมากขึ้น 18.1% ผู้วิจัยมองว่านี่คือ Simpson’s paradox FAQ ปรากฏใน 43% ของหน้าในกลุ่มเว็บไซต์หนึ่งในสี่ที่ถูกอ้างอิงมากที่สุด และใน 23% ของหน้าในกลุ่มหนึ่งในสี่ที่ถูกอ้างอิงน้อยที่สุด การเทียบข้ามเว็บไซต์จึงยกความดีให้ FAQ ทั้งที่ความจริงเป็นผลของตัวเว็บไซต์
มีคุณสมบัติสองข้อที่ผ่านการทดสอบความทนทานทั้งห้าข้อของงานวิจัย ข้อแรกคือชื่อหน้าที่ตรงกับคำถามที่คนถาม ถูกอ้างอิงมากขึ้น 14.1% ต่อหนึ่งส่วนเบี่ยงเบนมาตรฐาน 23.6% บนหน้าของบุคคลที่สาม และ 26.4% ในตลาด B2B ข้อที่สองคือย่อหน้าที่ตอบคำถามนั้น ย่อหน้าที่ดีที่สุดของหน้าเพิ่มการอ้างอิง 15.5% และ 25.7% บนหน้าของบุคคลที่สาม ทั้งสองข้อทำงานผ่านขั้นตอนเดียวกัน หน้าที่ชื่อและย่อหน้าตรงกับคำค้นของเอนจินในเชิงความหมายจะขยับขึ้นในรายการของมัน
| คุณสมบัติของหน้า | ความต่างของการถูกอ้างอิง | ทนทาน? |
|---|---|---|
| ย่อหน้าที่ดีที่สุดตอบคำถาม | +15.5% | ใช่ |
| ชื่อหน้าตรงกับคำถาม | +14.1% | ใช่ |
| Schema markup | +6.9% | ไม่ |
| หน้าโหลดเร็วกว่า | −1.1% | ไม่ |
| FAQ | −3.4% | ไม่ |
| กล่องสรุป | −4.6% | ไม่ |
| ประวัติผู้เขียน | −5.3% | ไม่ |
เมื่อหน้าเข้าไปอยู่ในรายการของเอนจินแล้ว ยังมีลักษณะบางอย่างที่มีผลต่อการเลือกขั้นสุดท้ายเมื่ออยู่อันดับเท่ากัน หน้าของแบรนด์ถูกอ้างอิงมากกว่า (×1.71) เช่นเดียวกับหน้าที่มีหัวข้อย่อยมากกว่า (×1.28) และหน้าที่สั้นกว่า ส่วนหน้าที่เป็นลิสต์ (×0.54) หน้าเปรียบเทียบ (×0.34) และกระทู้ Reddit (×0.30) ถูกเปิดดูบ่อยแต่ถูกอ้างอิงน้อย FAQ, schema และประวัติผู้เขียนไม่ช่วยอะไรในขั้นตอนนี้เช่นกัน
ความจำของโมเดลมีบทบาทอย่างไร?
โมเดลเขียนชื่อแบรนด์ที่มันรู้จักอยู่แล้วลงในคำค้น และเอ่ยถึงบางแบรนด์โดยไม่มีหน้าใดรองรับเลย เมื่อแบรนด์หนึ่งอยู่ในสิ่งที่โมเดลเชื่อมโยงกับคำถาม ChatGPT จะเติมชื่อแบรนด์นั้นลงในคำค้น 67% ของกรณี เทียบกับ 11% ในกรณีอื่น และ 46% ของแบรนด์ที่ ChatGPT เอ่ยถึงโดยที่คำถามไม่ได้ระบุ ไม่มีหน้าที่ถูกอ้างอิงใดรองรับ
ตลาดเฉพาะกลุ่มแสดงอีกด้านหนึ่ง โมเดลแทบไม่รู้จักผู้ขายซอฟต์แวร์รายเล็ก ChatGPT แทบไม่เคยเติมชื่อพวกเขาลงในคำค้น (3% เทียบกับ 28%) และค้นพบพวกเขาจากผลการค้นหารอบแรก หน้าของบุคคลที่สามที่ถูกอ้างอิงและเอ่ยชื่อผู้ขาย เพิ่มโอกาสที่ ChatGPT จะเอ่ยชื่อนั้นตามถึง 39.7 เท่า เทียบกับ 4.2 เท่าสำหรับแบรนด์ใหญ่ สำหรับแบรนด์ที่โมเดลไม่ค่อยรู้จัก การมองเห็นต้องอาศัยหน้าของบุคคลที่สามที่ระบบค้นหาของเอนจินค้นเจอ
ผลลัพธ์คงที่เมื่อเวลาผ่านไปหรือไม่?
ไม่ค่อยคงที่ สิ่งที่อธิบายการถูกอ้างอิงของเว็บไซต์เปลี่ยนเร็ว และเปลี่ยนเร็วยิ่งกว่าบน Perplexity ภายในช่วงสองสัปดาห์ ความต่างระหว่างหน้าเกิดซ้ำ 63% ถึง 67% สองสัปดาห์ต่อมา ส่วนที่เหมือนกันลดลงเหลือ 40% สำหรับ ChatGPT, 47% สำหรับ Gemini และ 22% สำหรับ Perplexity สิบสัปดาห์ต่อมาเหลือ 14%, 29% และ 0%
ผู้วิจัยระบุข้อจำกัดไว้ชัดเจน ผลลัพธ์เป็นความสัมพันธ์ ยกเว้นการทดลองแบบควบคุมในขั้นตอนการตอบ ทั้งสองตลาดอยู่ในสหรัฐฯ และใช้ภาษาอังกฤษ การทดสอบซ้ำใช้โมเดลขนาดเล็กผ่าน API ซึ่งไม่ใช่อินเทอร์เฟซที่ผู้ใช้ทั่วไปเห็น งานวิจัยอีกชิ้นที่ออกมาในวันถัดมา (arXiv:2610.15382) วัดช่องว่างนี้ได้ว่า API ของ OpenAI รวมกับ Google หา URL ที่ ChatGPT อ้างอิงในอินเทอร์เฟซเว็บได้เพียงราวหนึ่งในสี่ และหาเว็บไซต์ได้ราวครึ่งหนึ่ง
ยืนยันแล้ว: ในการทดสอบซ้ำผ่าน API ทุกหน้าที่ ChatGPT อ้างอิงถูกระบบค้นหาของมันค้นเจอมาก่อน และการค้นหานั้นอธิบายความต่างระหว่างหน้าในเว็บไซต์เดียวกันได้มากกว่าคุณสมบัติของหน้าอย่างมาก ยังไม่ยืนยัน: ว่าสัดส่วนเดียวกันใช้ได้กับอินเทอร์เฟซสาธารณะของ ChatGPT นอกสหรัฐฯ หรือในภาษาอื่นนอกจากภาษาอังกฤษ ยังไม่ได้ทดสอบ: ผลของการแทรกแซง เช่น การเขียนชื่อหน้าใหม่แล้ววัดการอ้างอิงก่อนและหลัง
KAIS เปลี่ยนอะไรในวิธีการทำงาน?
KAIS เพิ่มชั้น “คำค้นย่อยของเอนจิน” ในต้นไม้การถูกอ้างอิง ที่ผ่านมา ต้นไม้นี้เชื่อมคำถามเพื่อการตัดสินใจของผู้ซื้อเข้ากับคำถามรองที่ตามมา แล้วจึงไปยังแหล่งข้อมูลที่ตอบคำถามเหล่านั้น ตอนนี้มันผ่านการค้นหาของเอนจินด้วย คือ คำถาม คำค้นที่ถูกเขียนใหม่ หน้าที่ถูกค้นเจอ และหน้าที่ถูกอ้างอิง
- ชั้นที่ 1 · คำถามเพื่อการตัดสินใจ“ควรเลือกสำนักงานไหนช่วยจดทะเบียนบริษัทในไทย”
- ชั้นที่ 2 · คำค้นย่อยของเอนจิน ชั้นใหม่รับจดทะเบียนบริษัท 2026 ค่าจดทะเบียนบริษัท กรุงเทพ รีวิว สำนักงานกฎหมาย กรุงเทพ ชาวต่างชาติประมาณ 4 คำค้นต่อคำถาม เขียนใหม่ทุกคำตอบ
- ชั้นที่ 3 · หน้าที่ถูกค้นเจอรายการที่เอนจินจัดอันดับเอง มักอยู่นอก 50 อันดับแรกของ Googleเปิดดูประมาณ 26 หน้าต่อคำถาม
- ชั้นที่ 4 · หน้าที่ถูกอ้างอิงเลือกจากส่วนบนของรายการนั้นประมาณ 3 หน้าต่อคำถาม
สิ่งแรกที่เปลี่ยนคือการบันทึกผล KAIS บันทึกผลด้วยมือ ในอินเทอร์เฟซเดียวกับที่ผู้ซื้อเห็น เมื่อ ChatGPT แสดงการค้นหาที่มันทำ บันทึกจะเก็บคำค้นเหล่านั้นไว้แบบคำต่อคำ สิ่งที่อินเทอร์เฟซไม่แสดงจะเว้นว่างไว้ เราไม่เดา และเพราะคำค้นเปลี่ยนไปในแต่ละคำตอบ เราจึงอ่านสิ่งที่เกิดซ้ำในหลายรอบ ไม่ใช่คำค้นเพียงคำเดียว
สิ่งต่อมาคือการวินิจฉัย หน้าที่ไม่ปรากฏในคำตอบอาจล้มเหลวได้สองจุด จุดแรก ระบบค้นหาของเอนจินหาหน้านั้นไม่เจอ การแก้เนื้อหาจึงไม่ช่วยอะไร จนกว่าชื่อหน้าและย่อหน้าจะตรงกับคำค้นเหล่านั้น จุดที่สอง หน้าถูกค้นเจอแต่ไม่ถูกเลือก กรณีนี้สิ่งที่อยู่ในหน้าเมื่ออยู่อันดับเท่ากันจะเป็นตัวตัดสิน ต้นไม้แบบเดิมแยกสองกรณีนี้ไม่ออก วิธีวินิจฉัยหน้าที่เจาะจงอธิบายไว้ใน ทำไม AI ไม่อ้างอิงหน้าเว็บของคุณ
สิ่งสุดท้ายคือการผลิตเนื้อหา หนึ่งหน้า หนึ่งคำถาม ชื่อหน้าที่ใช้คำถามแบบเดียวกับที่ผู้ซื้อถาม ย่อหน้าแรกที่ตอบได้ครบในตัวเอง และสำหรับแบรนด์ที่โมเดลไม่ค่อยรู้จัก ต้องมีหน้าของบุคคลที่สามที่เอ่ยชื่อแบรนด์ในคำถามที่ถูกต้อง ยังมีอีกประเด็นที่ต้องตรวจสอบ ซึ่งเป็นการตีความของ KAIS ไม่ใช่ข้อค้นพบของงานวิจัย เนื่องจากเกือบหนึ่งในสี่ของคำค้นเติมปีลงไป หน้าที่ระบุวันที่และอัปเดตสม่ำเสมออาจตรงกับคำค้นเหล่านั้นได้ดีกว่า
สี่หลักที่งานวิจัยสนับสนุน
- ชื่อหน้าที่ตั้งเป็นคำถาม: หนึ่งในสองคุณสมบัติเท่านั้นที่สัมพันธ์กับการถูกอ้างอิงภายในเว็บไซต์
- ย่อหน้าที่ตอบได้ในตัวเอง: ย่อหน้าที่ดีที่สุดของหน้ามีน้ำหนักพอ ๆ กับชื่อหน้า
- หน้าของบุคคลที่สามสำหรับแบรนด์ที่ไม่ค่อยมีคนรู้จัก: ×39.7 ในตลาดเฉพาะกลุ่มที่ศึกษา
- อย่าใส่ FAQ หรือ schema เพื่อหวังการอ้างอิง: อาจช่วยผู้อ่าน แต่ไม่พบผลภายในเว็บไซต์เดียวกัน
เรื่องนี้อยู่ตรงไหนใน AI Visibility Chain ของ KAIS?
งานวิจัยนี้อยู่ในขั้นที่สองของ AI Visibility Chain ของ KAIS คือ Be Retrieved และแสดงว่า Be Cited ขึ้นอยู่กับขั้นนี้ทั้งหมด
Be Discovered → Be Retrieved → Be Understood → Be Trusted → Be Cited → Influence the Answer → Be Recommended
งานวิจัยยังแตะขั้น Be Trusted ผ่านความจำของโมเดล เว็บไซต์ที่โมเดลเชื่อมโยงกับคำถามอยู่แล้วจะอยู่อันดับสูงกว่าในรายการ และมีโอกาสถูกอ้างอิงมากกว่า 1.60 เท่าเมื่ออยู่อันดับเท่ากัน ความจำทำงานทั้งก่อนการค้นหา ด้วยการป้อนชื่อแบรนด์ และหลังการค้นหา ด้วยการเอ่ยชื่อแบรนด์โดยไม่มีแหล่งอ้างอิง
เอนจินตั้งคำถามของตัวเอง
หลายปีที่ผ่านมา การทำ SEO คือการเดาคำที่ผู้ใช้พิมพ์ เอนจินคำตอบเพิ่มตัวกลางเข้ามาอีกหนึ่งชั้น มันอ่านคำถาม เขียนคำค้นของตัวเอง และอ้างอิงเฉพาะสิ่งที่คำค้นเหล่านั้นหามาได้
หน้าเว็บอาจเขียนดี ติด markup ครบ โหลดเร็ว แต่ไม่เคยถูกอ้างอิงเลย เพราะไม่มีคำค้นใดหาเจอ นี่คือชั้นที่ต้นไม้เคยขาดไป
แหล่งที่มาและเอกสารอ้างอิง
- Chen และ Koudas — What Drives AI Citations? Content, Retrieval and Model Knowledge in Generative Engine Optimization (GEO), arXiv:2610.15033 [cs.IR], 10 ตุลาคม 2026, มหาวิทยาลัยโทรอนโต ฉบับแรก ยังไม่ผ่านการประเมินโดยผู้ทรงคุณวุฒิ ข้อมูล (ส่วนที่ 3) คุณสมบัติของหน้าภายในเว็บไซต์และ Simpson’s paradox (ส่วนที่ 4) ความคงที่ตามเวลา (ส่วนที่ 5) การทดสอบซ้ำ อันดับ และคำค้นย่อย (ส่วนที่ 6.1 ถึง 6.3) สัดส่วนที่การค้นคืนอธิบายได้ (ส่วนที่ 6.4) ความรู้ของโมเดล (ส่วนที่ 6.5) ตลาดที่สอง (ส่วนที่ 7) ตัวเลขทั้งหมดในบทความนี้มาจากงานวิจัย KAIS ไม่ได้ทำซ้ำหรือวัดใหม่
- Jiang, Zhang, Xing, Chang และ Xiao — Understanding ChatGPT Citations: Evidence from Production Web Search Across Model Generations, arXiv:2610.15382 [cs.IR], 11 ตุลาคม 2026 ช่องว่างระหว่าง API ของ OpenAI, Google และอินเทอร์เฟซเว็บของ ChatGPT: หา URL ที่ถูกอ้างอิงได้ 26% ถึง 28%